
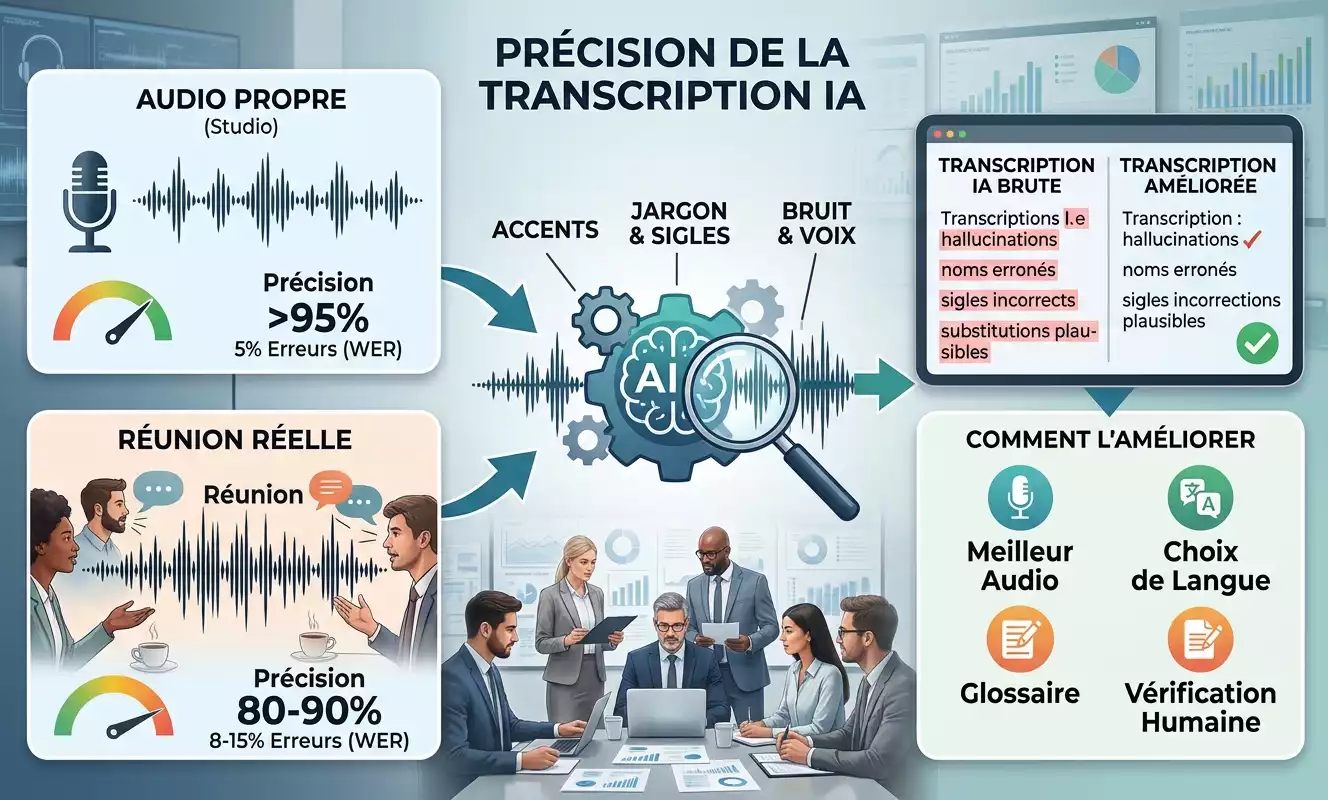
La précision d’une transcription automatique en français se mesure avec le taux d’erreur de mots, ou WER. Sur un enregistrement propre, les meilleurs moteurs affichent environ 5 % d’erreurs. Sur une vraie réunion, avec des accents, du jargon et des voix qui se chevauchent, l’écart se creuse nettement.
Voici l’essentiel en trois points :
- Un pourcentage unique ne prédit rien. Un score de 98 % obtenu sur un audio de studio ne garantit pas le même résultat sur vos réunions.
- Trois facteurs pèsent le plus : l’accent du locuteur, le vocabulaire métier et la qualité de l’enregistrement.
- Quatre leviers fonctionnent : un bon enregistrement, la gestion de la langue, un vocabulaire personnalisé et une relecture ciblée.
Cet article détaille chaque point avec des mesures publiées, indique leurs limites et propose une méthode pour tester un outil sur vos propres enregistrements.
Table des matières
- Comment mesurer la précision d’une transcription automatique ?
- Quelle précision attendre en français ?
- Accents : pourquoi la précision varie selon les locuteurs
- Jargon métier, sigles et noms propres
- Bruit, voix superposées et hallucinations
- Comment améliorer la précision de la transcription
- Comment tester un outil sur vos propres enregistrements ?
- Questions fréquentes
Comment mesurer la précision d’une transcription automatique ?
Le WER compare le texte produit par le moteur à une transcription de référence rédigée par un humain. Il additionne les mots remplacés, ajoutés et supprimés, puis divise ce total par le nombre de mots de la référence (définition issue d’une publication du TALN 2022).
Un WER de 10 % signifie donc environ un mot erroné sur dix. En langage courant, cela correspond à une précision proche de 90 %.
Pourquoi le WER ne suffit pas
Le WER traite toutes les erreurs de la même façon. Une faute d’accord et un montant erroné comptent chacun pour un mot, alors que leurs conséquences n’ont rien de comparable.
Une équipe de trois universités françaises (Nantes, Le Mans, Avignon) propose de classer les erreurs en quatre niveaux de gravité. Le premier regroupe les fautes que le lecteur corrige sans effort. Le dernier regroupe les erreurs qui rendent la phrase incompréhensible ou, pire, qui passent inaperçues parce que le mot erroné paraît cohérent dans son contexte.
Les scores annoncés par les éditeurs
Les mentions « jusqu’à 99 % » sont des plafonds, pas des moyennes. Un guide publié par l’éditeur Sonix indique lui-même que la plupart des outils atteignent entre 85 et 95 % sur de l’audio anglais sans interférence. Les tableaux comparatifs publiés par un éditeur sur son propre site sont à lire avec le même recul.
Quelle précision attendre en français ?
La réponse dépend du type de parole. Deux situations donnent des ordres de grandeur très différents.
Parole lue et audio propre : environ 5 à 12 % d’erreurs
Sur le benchmark FLEURS en français, un corpus de parole lue, le tableau publié par Speechmatics affiche un WER de 4,62 % pour son propre moteur et de 5,6 % pour Whisper large-v3 d’OpenAI. Amazon Transcribe, Microsoft Azure, Deepgram Nova-2 et Google Chirp 2 s’échelonnent de 5,96 % à 12,31 %. Ces chiffres viennent d’un éditeur et mesurent des conditions favorables.
Parole spontanée en conditions réelles : environ 8 à 15 % d’erreurs
Le Centre de recherche informatique de Montréal (CRIM) a comparé 24 modèles sur des audiences publiques québécoises : conversations spontanées, avec écho et bruit de fond. Le meilleur modèle public atteint environ 8 % de WER. Les modèles courants se regroupent autour de 14 %.
Les auteurs constatent aussi que les scores obtenus sur FLEURS et Common Voice, des corpus de parole lue et propre, ne permettent pas de prédire ces résultats.
Pour une réunion francophone ordinaire, comptez donc plutôt 8 à 15 % d’erreurs, soit une précision de 85 à 92 %. Il s’agit d’un ordre de grandeur : à notre connaissance, aucune étude publique ne mesure une réunion d’entreprise française type. Un enregistrement bruyant ou très accentué donnera davantage d’erreurs.
Accents : pourquoi la précision varie selon les locuteurs
Un moteur de reconnaissance vocale reconnaît mieux ce qu’il a beaucoup entendu pendant son entraînement. Whisper, par exemple, a été entraîné sur 680 000 heures d’audio multilingue. Les accents peu représentés dans ces données sont moins bien reconnus.
Les accents régionaux du français
L’étude du CRIM estime que le français québécois représente moins de 5 % de la durée des enregistrements français de Common Voice. Sur cet accent, les écarts entre modèles sont importants : le WER va de 8,4 % pour Whisper large-v3 à 33 % pour Whisper small.
Deux variantes de Whisper affinées pour le français ont obtenu un WER légèrement supérieur à celui du modèle multilingue d’origine (9,2 % et 10,1 % contre 8,4 %). Spécialiser un modèle pour le français ne garantit donc pas un meilleur résultat, au moins dans ce test.
Pour le français de Belgique, de Suisse ou d’Afrique, aucune mesure publique comparable n’a été trouvée. Le mécanisme décrit ci-dessus est vraisemblablement le même : plus une variété est rare dans les données, plus le risque d’erreur augmente.
Locuteurs non natifs et variétés minoritaires
Ces écarts sont documentés surtout pour l’anglais. Une étude parue dans PNAS a testé cinq systèmes commerciaux (Amazon, Apple, Google, IBM, Microsoft) : le WER moyen atteint 0,35 pour les locuteurs noirs américains, contre 0,19 pour les locuteurs blancs. Les auteurs relient ces écarts aux modèles acoustiques et recommandent des données d’entraînement plus diversifiées.
Une étude de JASA Express Letters consacrée à Whisper observe de meilleurs résultats sur les accents natifs que sur les accents non natifs, et sur la parole lue que sur la conversation.
Ces travaux portent sur l’anglais. Ils montrent un mécanisme, pas des chiffres transposables au français.
Jargon métier, sigles et noms propres
Les moteurs généralistes se trompent plus souvent sur les mots rares. La documentation d’Amazon Transcribe le dit clairement : les termes propres à un domaine, les noms de marque, les sigles et le jargon technique peuvent ne pas être correctement reconnus.
Le risque principal n’est pas la faute visible. C’est la substitution plausible : un mot courant à la place d’un terme technique, qui s’intègre bien dans la phrase. Dans la typologie des chercheurs français citée plus haut, ces erreurs font partie des plus graves, car le lecteur ne les détecte pas.
HappyScribe cite les mêmes points de vigilance. Voici ce qu’il faut vérifier en priorité dans une transcription :
- les chiffres, montants et dates ;
- les noms de personnes, de clients et de produits ;
- les sigles et références techniques ;
- les négations, qui inversent le sens d’une phrase.
Bruit, voix superposées et hallucinations
La qualité de l’audio influence directement le résultat. Le corpus québécois évoqué plus haut contient de la réverbération, du bruit de fond et des chevauchements de voix, des conditions proches de celles d’une salle de réunion. Les auteurs précisent qu’ils ne peuvent pas attribuer les erreurs à une cause unique.
Les prises de parole simultanées restent un point faible reconnu. Selon HappyScribe, l’IA peut y rencontrer des difficultés, là où un transcripteur humain peut réécouter un passage.
Les hallucinations
Un moteur peut aussi écrire une phrase que personne n’a prononcée. Une étude présentée à la conférence ACM FAccT 2024 a mesuré ce phénomène sur Whisper : environ 1 % des transcriptions contenaient des phrases entières inventées, et 38 % de ces hallucinations comportaient un contenu explicitement nuisible.
Les données venaient d’un corpus de personnes aphasiques, et les silences longs favorisaient le phénomène. Selon l’autrice principale, le taux a baissé depuis l’expérience menée au printemps 2023 (Cornell University).
Une phrase inventée mais bien construite se repère moins facilement qu’une faute d’orthographe. Les passages critiques se vérifient donc toujours à l’écoute.
Comment améliorer la précision de la transcription
Quatre leviers sont à votre portée.
1. Soigner l’enregistrement
- Utiliser des micros dédiés aux intervenants.
- Séparer les canaux audio quand l’outil le permet.
- Demander aux participants d’éviter de parler en même temps.
- Limiter le bruit de fond et l’écho de la salle.
Les trois premières recommandations viennent de la FAQ de HappyScribe. La qualité de l’enregistrement est le levier le plus simple à actionner, car il ne dépend d’aucun réglage logiciel.
2. Gérer la langue et l’alternance de langues
Vérifiez que l’outil est réglé sur le français. Si vos réunions mélangent français et anglais, assurez-vous qu’il gère explicitement l’alternance de langues. Notre article sur la transcription IA multilingue en entreprise détaille ce cas.
3. Fournir un vocabulaire personnalisé
Beaucoup de moteurs acceptent une liste de termes à reconnaître. Chez Amazon Transcribe, un vocabulaire personnalisé sert à corriger les noms de marque et les sigles. Un modèle de langage personnalisé, lui, apprend le contexte à partir de grands volumes de texte du domaine et distingue par exemple deux homophones selon la phrase (documentation AWS).
D’après le blog d’AWS, plus la liste est ciblée sur l’enregistrement traité, meilleur est le résultat. HappyScribe propose de son côté des glossaires personnalisés pour les noms propres et la terminologie spécialisée.
Préparez une liste courte avant chaque réunion : noms des participants, clients, produits, sigles.
4. Relire ce qui compte
Relisez en priorité les chiffres, les noms, les décisions et les négations. Réécoutez l’extrait correspondant grâce à l’horodatage.
Pour une réunion d’équipe interne, une relecture ciblée suffit souvent. Pour un document engageant, la relecture complète s’impose. Cette logique vaut aussi pour un compte rendu de réunion automatique.
Comment tester un outil sur vos propres enregistrements ?
Les benchmarks publics ne prédisent pas le résultat sur vos audios, comme l’a montré l’étude du CRIM. Le plus fiable consiste à tester vous-même, avec une méthode simple :
- Choisir trois extraits de cinq minutes : une réunion calme, un échange avec des accents variés, un enregistrement bruyant.
- Préparer une transcription de référence, écrite ou relue à la main.
- Passer les mêmes extraits dans chaque outil, avec la langue et le vocabulaire réglés de la même façon.
- Calculer le WER, par exemple avec la bibliothèque libre jiwer.
- Noter les erreurs graves (chiffres, noms, négations) et chronométrer le temps de correction, comme le conseille HappyScribe.
Plusieurs moteurs se prêtent à cette comparaison : Whisper d’OpenAI (open source), Amazon Transcribe, Speechmatics ou HappyScribe. Pour les réunions, Gaia Scribe, la solution de transcription de Gaia Cloud, prend en charge plus de 30 langues, héberge ses données en France et en Europe et propose un essai gratuit de deux heures, de quoi réaliser ce test. Un comparatif des logiciels de retranscription de réunion donne un panorama plus large.
Questions fréquentes
Sur un audio propre, le WER se situe entre 5 et 12 % selon le moteur, soit 88 à 95 % de précision. Sur une réunion spontanée avec bruit et accents, comptez plutôt 8 à 15 % d’erreurs, voire davantage. Ces chiffres sont des ordres de grandeur issus d’un benchmark d’éditeur et d’une étude sur le français québécois.
C’est un maximum obtenu dans de bonnes conditions, pas une moyenne. L’étude du CRIM montre que les scores sur des corpus de parole lue ne prédisent pas les résultats sur de la parole spontanée. Demandez la méthode de mesure et testez sur vos propres enregistrements.
Elle les comprend de façon inégale. Les accents bien représentés dans les données d’entraînement sont mieux reconnus que les accents rares. Sur le français québécois, le WER varie de 8,4 % à 33 % selon le modèle testé. Aucune mesure publique comparable n’a été trouvée pour les autres accents francophones.
Fournissez un vocabulaire personnalisé : noms de produits, sigles, noms de clients. Des moteurs comme Amazon Transcribe et HappyScribe proposent cette fonction. Gardez la liste courte et ciblée sur chaque enregistrement, puis relisez les termes techniques.
Oui, au moins les passages qui comptent. Les chiffres, les noms et les négations changent le sens d’une phrase, et un moteur peut parfois inventer un passage. Pour un compte rendu interne, une relecture ciblée suffit souvent. Pour un document engageant, relisez l’ensemble en vous aidant de l’audio.